John Mueller explica por qué Google indexa solo cuatro páginas de un agregador masivo
John Mueller, de Google, ha explicado por qué un agregador de productos con más de un millón de rastreos solo mantiene cuatro páginas indexadas. Los fallos técnicos en las redirecciones y el contenido automatizado a gran escala impiden su indexación.
Lo que se sabe
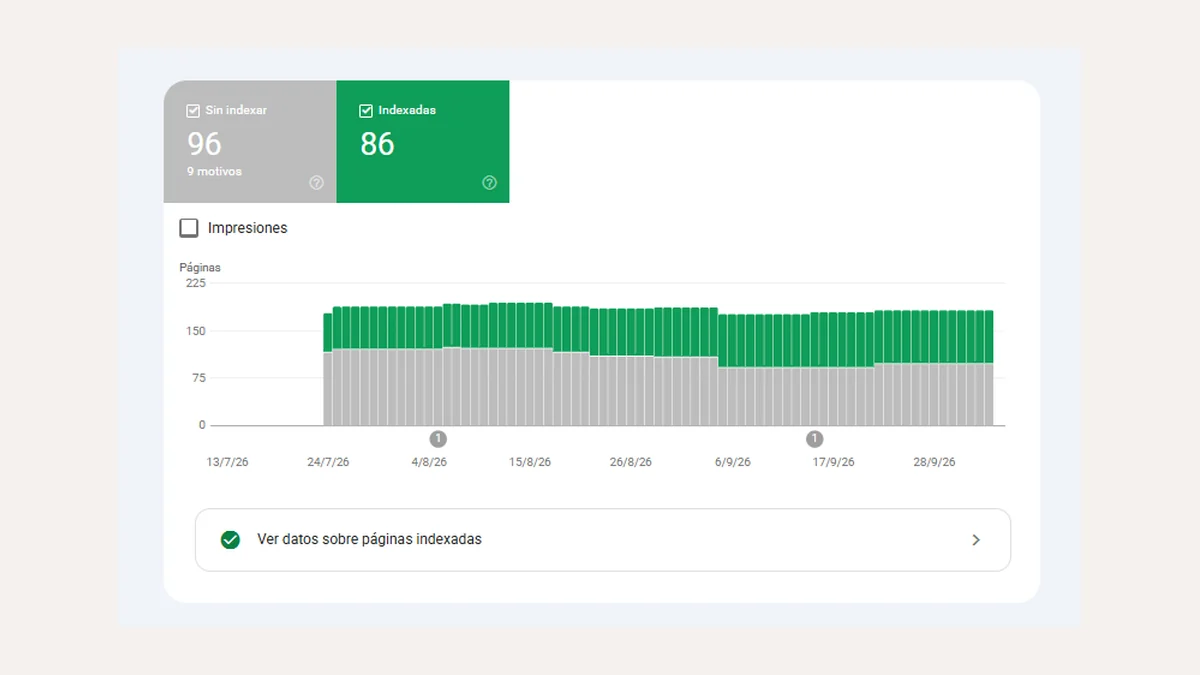
John Mueller, portavoz técnico de Google, respondió en la red social Bluesky a las dudas sobre el sitio ponito.com. Este portal de agregación de productos registró 1,17 millones de rastreos por parte de Googlebot (el robot de búsqueda de Google) en pocas semanas. Sin embargo, el informe de indexación de Google Search Console reflejaba que solo cuatro páginas de un total de 180.000 estaban indexadas, quedando excluida la propia página de inicio.
Mueller identificó dos problemas principales en este caso. El primero es un fallo técnico de arquitectura: varias de las páginas que estaban indexadas redirigían directamente a la página de inicio del sitio. El segundo es la falta de valor del contenido, al tratarse de un agregador masivo que utiliza "programmatic SEO" (SEO programático, es decir, la creación automatizada de miles de páginas de destino basadas en bases de datos).
Contexto
El SEO programático ha sido una táctica habitual para generar directorios y portales de servicios masivos con el objetivo de captar búsquedas de larga cola de forma rápida.
Cómo funciona
El "crawling" (rastreo) es un proceso independiente de la indexación. Googlebot puede visitar y descargar millones de páginas de un sitio web para analizarlas. Sin embargo, si durante este proceso el motor de búsqueda detecta redirecciones inconsistentes o contenido autogenerado que no aporta valor diferencial sobre las fuentes originales, los algoritmos descartan incluir esas URLs en el índice final de resultados.
Lo que solo se ha anunciado
Mueller ha afirmado que crear y mantener correctamente un agregador de productos no es una tarea trivial. Según el portavoz, convencer tanto a los motores de búsqueda como a los usuarios de que este tipo de plataformas automatizadas aportan un valor real es sumamente complejo, señalando que Google generalmente no es partidario del SEO programático sin valor añadido.
Qué significa para tu negocio
Para las empresas de servicios B2B en España que recurren a directorios o agregadores de servicios, este caso demuestra que un elevado volumen de rastreo por parte de Googlebot no asegura visibilidad ni captación de "leads" (contactos comerciales). La automatización de páginas sin un estricto control técnico y sin valor propio bloquea su indexación.
Qué puedes hacer
- Auditar periódicamente las redirecciones de la web para asegurar que no existan bucles o redirecciones masivas hacia la página de inicio.
- Evaluar el valor único del contenido automatizado para garantizar que aporta datos útiles que no estén ya disponibles en la fuente original.
- Contrastar en Google Search Console si el volumen de rastreo se traduce de manera efectiva en páginas indexadas.
Preguntas frecuentes
¿Por qué Google rastreó un sitio web más de un millón de veces pero solo indexó cuatro páginas?
Debido a fallos técnicos en la configuración de las redirecciones hacia la página de inicio y al uso de contenido automatizado a gran escala sin valor diferencial.
¿Qué es el SEO programático en el contexto de este caso?
Es la generación masiva de páginas web mediante procesos automatizados, algo común en grandes agregadores de productos para intentar captar tráfico de búsqueda.
¿Garantiza el rastreo constante de Googlebot la indexación de las páginas?
No. El rastreo es el proceso de descubrimiento de URLs, pero Google solo las indexará si el sitio está técnicamente optimizado y ofrece contenido útil.